01CUDA
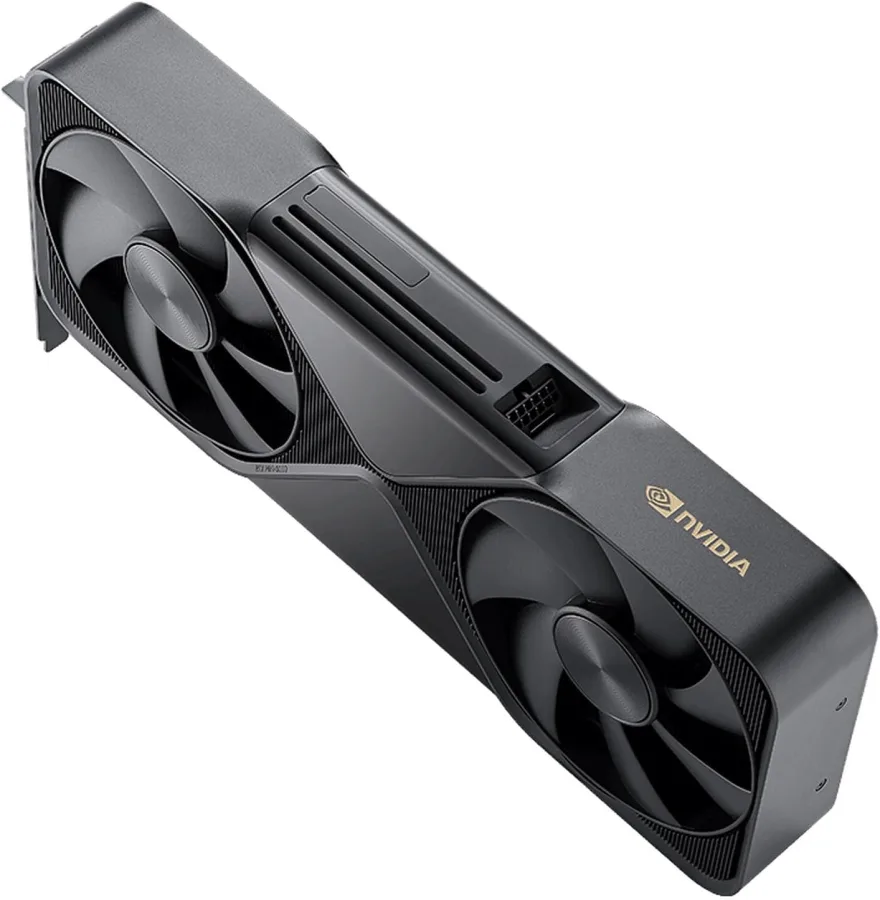
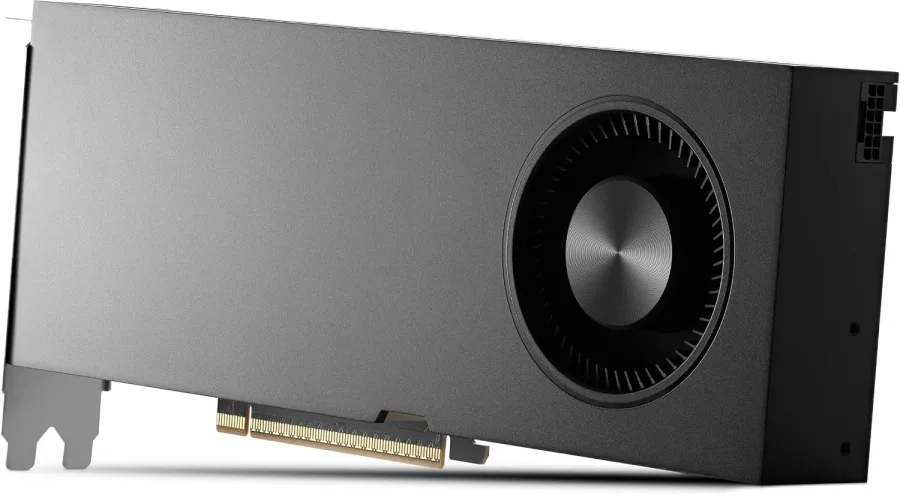
NVIDIA RTX PRO 6000 Blackwell (96 GB)
96GB
GDDR7
GDDR7
- VRAM
- Ancho
Hasta Llama 3.3 70B en Q4, 1792 GB/s
La GPU profesional más bestia que cabe en un PC: 96 GB de VRAM en una sola tarjeta gráfica.
GPU, mini PCs y Mac elegidos por lo que importa para la IA: VRAM, ancho de banda y qué modelo te cabe. Nada de FPS en juegos.
En una GPU para IA lo que manda es la VRAM: decide qué modelos caben.
17 equiposSi el presupuesto manda, busca VRAM antes que potencia.
7 equiposPara generar imágenes, CUDA marca la diferencia: casi todas las herramientas (ComfyUI, Forge) están pensadas para NVIDIA.
6 equiposLa memoria unificada permite cargar modelos de 70B o más sin comprar varias gráficas.
4 equiposLos Mac con mucha memoria unificada son la forma más silenciosa de correr modelos grandes.
3 equiposPequeñas, de bajo consumo y con aceleración de IA: para cámaras inteligentes, robots o un asistente de voz en casa..
1 equiposSon las tarjetas gráficas de 3.000, 10.000 o más de 20.000 euros que ves en las estaciones de trabajo de IA.
6 equiposMueve la memoria y mira qué modelos te caben. Te decimos el equipo más ajustado que lo cumple.
Memoria de tu GPU
Estimación: parámetros × bits ÷ 8, más un 20 % para contexto y caché. Los modelos de imagen usan su consumo típico.
Ordenados por lo que más pesa en IA: VRAM, ancho de banda y ecosistema de software. Así puntuamos.
Hasta Llama 3.3 70B en Q4, 1792 GB/s
La GPU profesional más bestia que cabe en un PC: 96 GB de VRAM en una sola tarjeta gráfica.
Hasta Qwen 2.5 32B en Q4, 1792 GB/s
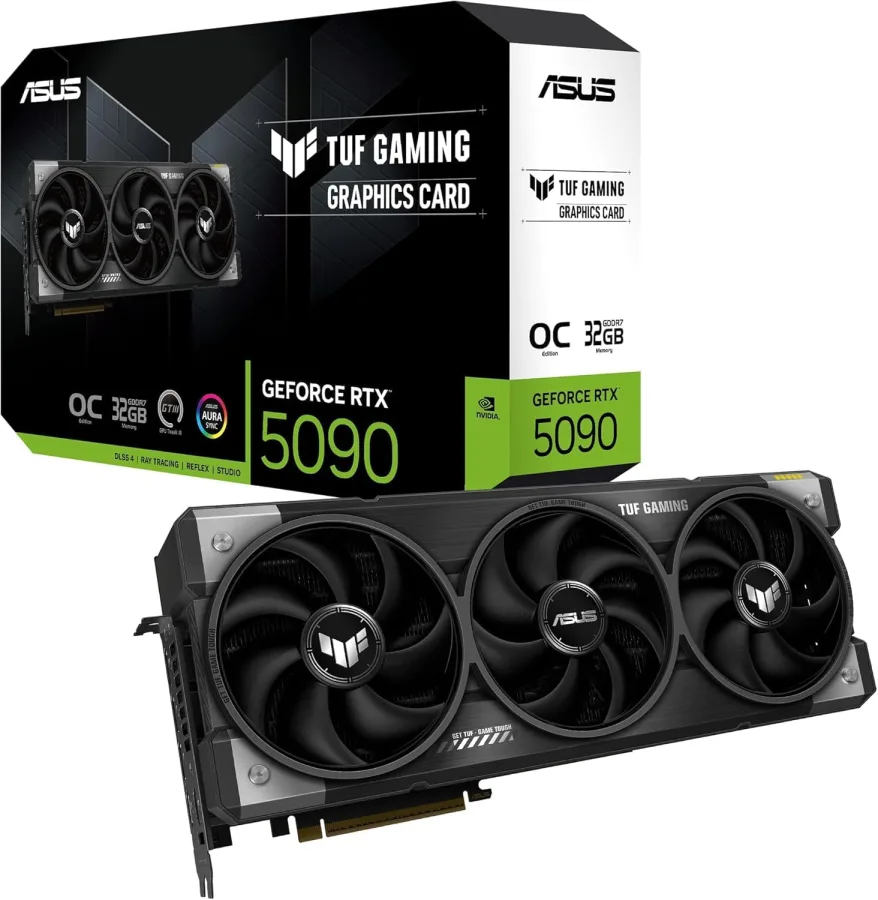
La gráfica de consumo más potente para IA en casa: 32 GB y el mayor ancho de banda que puedes poner en un PC.
Hasta Llama 3.3 70B en Q4, 1344 GB/s
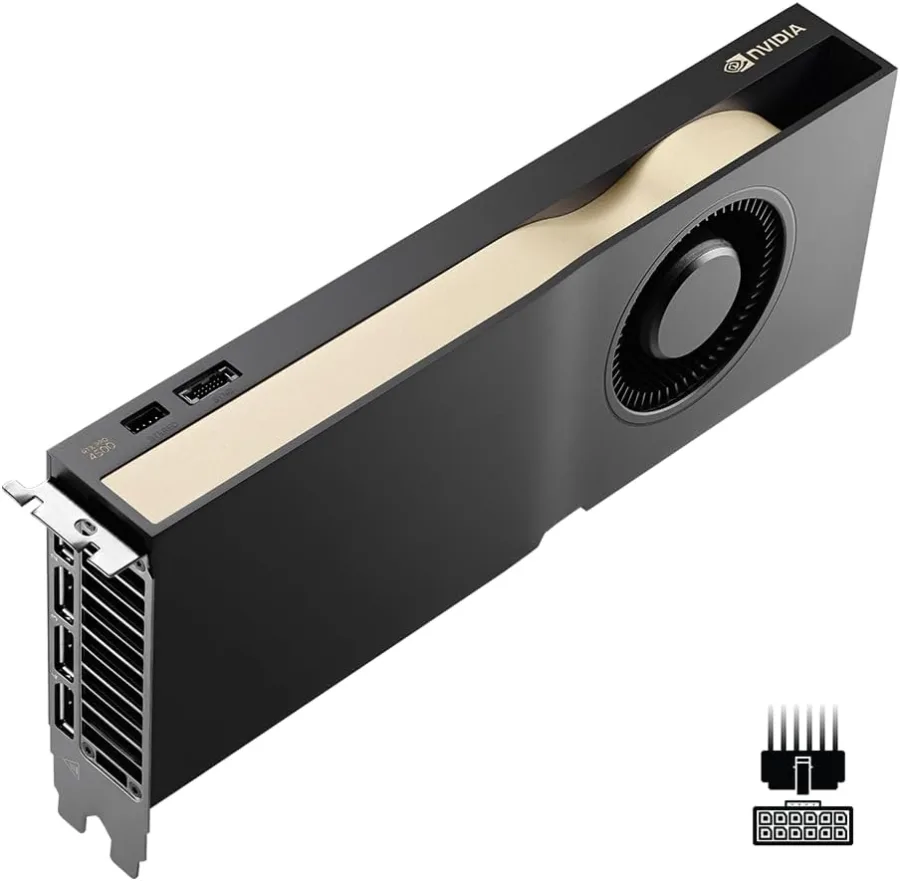
El punto dulce de las GPU profesionales: 48 GB de VRAM con solo 300 W.
Hasta Qwen 2.5 32B en Q4, 896 GB/s
Los mismos 32 GB que una RTX 5090 con un tercio del consumo y, hoy, por menos dinero.
Hasta Llama 3.3 70B en Q4, 273 GB/s
Superordenador de escritorio con 128 GB y stack CUDA completo.
Hasta Qwen 2.5 14B en Q4, 960 GB/s
Muy rápida generando, pero con 16 GB se queda en modelos medianos.
La VRAM: decide qué modelos caben. Después, el ancho de banda de memoria, que marca cuántos tokens por segundo genera. Los FPS en juegos no dicen nada sobre IA.
Porque en Amazon cambian varias veces al día. Preferimos llevarte al precio real en Amazon antes que enseñarte uno viejo.
Con enlaces de afiliado de Amazon: si compras desde ellos, Amazon nos paga una pequeña comisión sin que tú pagues más. No cobramos a marcas por aparecer.
Son una estimación propia a partir del ancho de banda y el tamaño del modelo, no un benchmark. La fórmula está publicada en "Cómo elegimos".